读 Anthropic 的 Agent Memory:怎么让 Agent 下次少踩一次坑
本文最后更新于:2026年11月17日 凌晨
今天早上刷到微信公众号推的文章:The components of agent memory。之前看 Agent 的上下文工程,更多关注的是上下文快满了怎么办、工具返回太长怎么办,以及怎么用 subagent 分担任务。
这篇文章让我想到了另一个问题:这次好不容易解决的问题,下次换一个对话,Agent 会不会又从头折腾一遍?
最直接的办法,应该就是把经验写下来。但接着又有几个问题:每次聊完都写一份总结吗?所有内容都放到一个 经验.md 里面吗?下次 Agent 真的会去看吗?万一上次记错了怎么办?
读着读着,我发现自己之前写的 agent-notes skill,其实已经在做其中一部分事情了。这篇就结合自己的项目和这个 skill,记一下我学到了什么。
先分清:接着做,和下次还记得
这篇文章讨论的 memory,关心的是跨会话留下来的经验。原文也专门把它和 compaction 区分开了。原文:Memory notes
用我自己的理解举个例子:
- “这个任务还差两个文件没改。”这是接着完成当前任务需要的信息。
- “这个兼容分支不能直接删,因为还有旧设备在用。”这可能是以后修改项目也需要知道的信息。
两种都可以写到文件里,但保存的目的不一样。前一种任务完成后可能就没用了,后一种如果没留下来,下一个 Agent 很可能不知道当时为什么这样写。
我以前更多关注怎么压缩,现在觉得还得问一句:这次做完,有什么东西值得让下一个 Agent 知道?
写下来之前,先看看自己到底确认了什么
一开始我想,既然需要记忆,那每次对话结束总结一下不就好了?
但仔细想想,总结也可能把错误留下来。
假设机器人出了故障,重启某个服务之后恢复了。如果 Agent 直接记成“这个报错重启服务就能解决”,下次它可能又照着做。
可我们当时真的确认原因了吗?会不会刚好是网络恢复了?会不会同时还做了其他操作?
所以这里我学到的一点是:记录的时候,把“发生了什么”和“为什么发生”分开。
1 | |
这样写,下一次至少知道它只是一个排查线索。如果直接写成确定的解决方案,就很容易把猜测当成经验反复用。
我也不觉得应该每次对话都留一篇总结。普通改字、调整样式,没有必要单独记。真正值得留下来的,是那些以后还可能遇到、重新查起来又比较麻烦的东西,比如一个不明显的兼容限制,或者某个方案最后没采用的原因。
之前我自己写了一个 agent-notes skill。它主要记录项目里的重要技术决策:为什么选这个方案,考虑过什么替代方案,有什么代价,以及什么情况下需要重新考虑,有点类似于 opensepc。
它把记录放在项目自己的 .agents/notes/ 里面,通过 AGENTS.md 引导 Agent 修改相关模块前先查记录。提案、已经实施的决定、明确否决的方案,也分别保存。skill 定义
比如下面这个假设场景,就很适合用它记录。
项目里有一段看上去多余的兼容代码。新开的对话里,Agent 觉得可以简化,准备删掉。但当初保留它,是因为某些旧设备还不支持新的处理方式。
代码能告诉它“这里做了兼容”,却不一定能告诉它:为什么现在还要兼容,能不能删,删了会影响谁。
如果有这样一条记录,就容易理解得多:
1 | |
这只是示例,不是实际项目记录。但它能说明我想保存的内容:后续的人和 Agent,需要知道当时为什么做这个决定。
文件写了,还得真的去读
以前我会更关心记录有没有写完整。读完这篇文章后,我觉得还得验证它到底有没有被用上。
我的 skill 已经在模板里要求:修改相关模块前先查 notes;有重要决定时,在同一次变更中创建或更新记录。不过,有这条要求,不代表每次都执行到了。
我接下来想做个很简单的检查:记录一个真实的兼容约束,开一个新对话,让 Agent 修改相关模块。看看它会不会主动找到那条记录,方案里有没有考虑这个限制。
如果它没查,就得看看入口是不是不明显、文件是不是不好找,或者指令有没有被执行。文件写得再详细,后续一直没人读,也帮不上忙。
这里也不能把 implemented 理解成“永远正确”。它说明这个决定已经有实现依据,但项目升级了、设备范围变了,原来的选择仍然可能需要调整。
那和 Dreaming 有什么关系
原文把后台回看记录、纠正笔记、重新组织记忆的过程叫作 Dreaming。原文:Dreaming
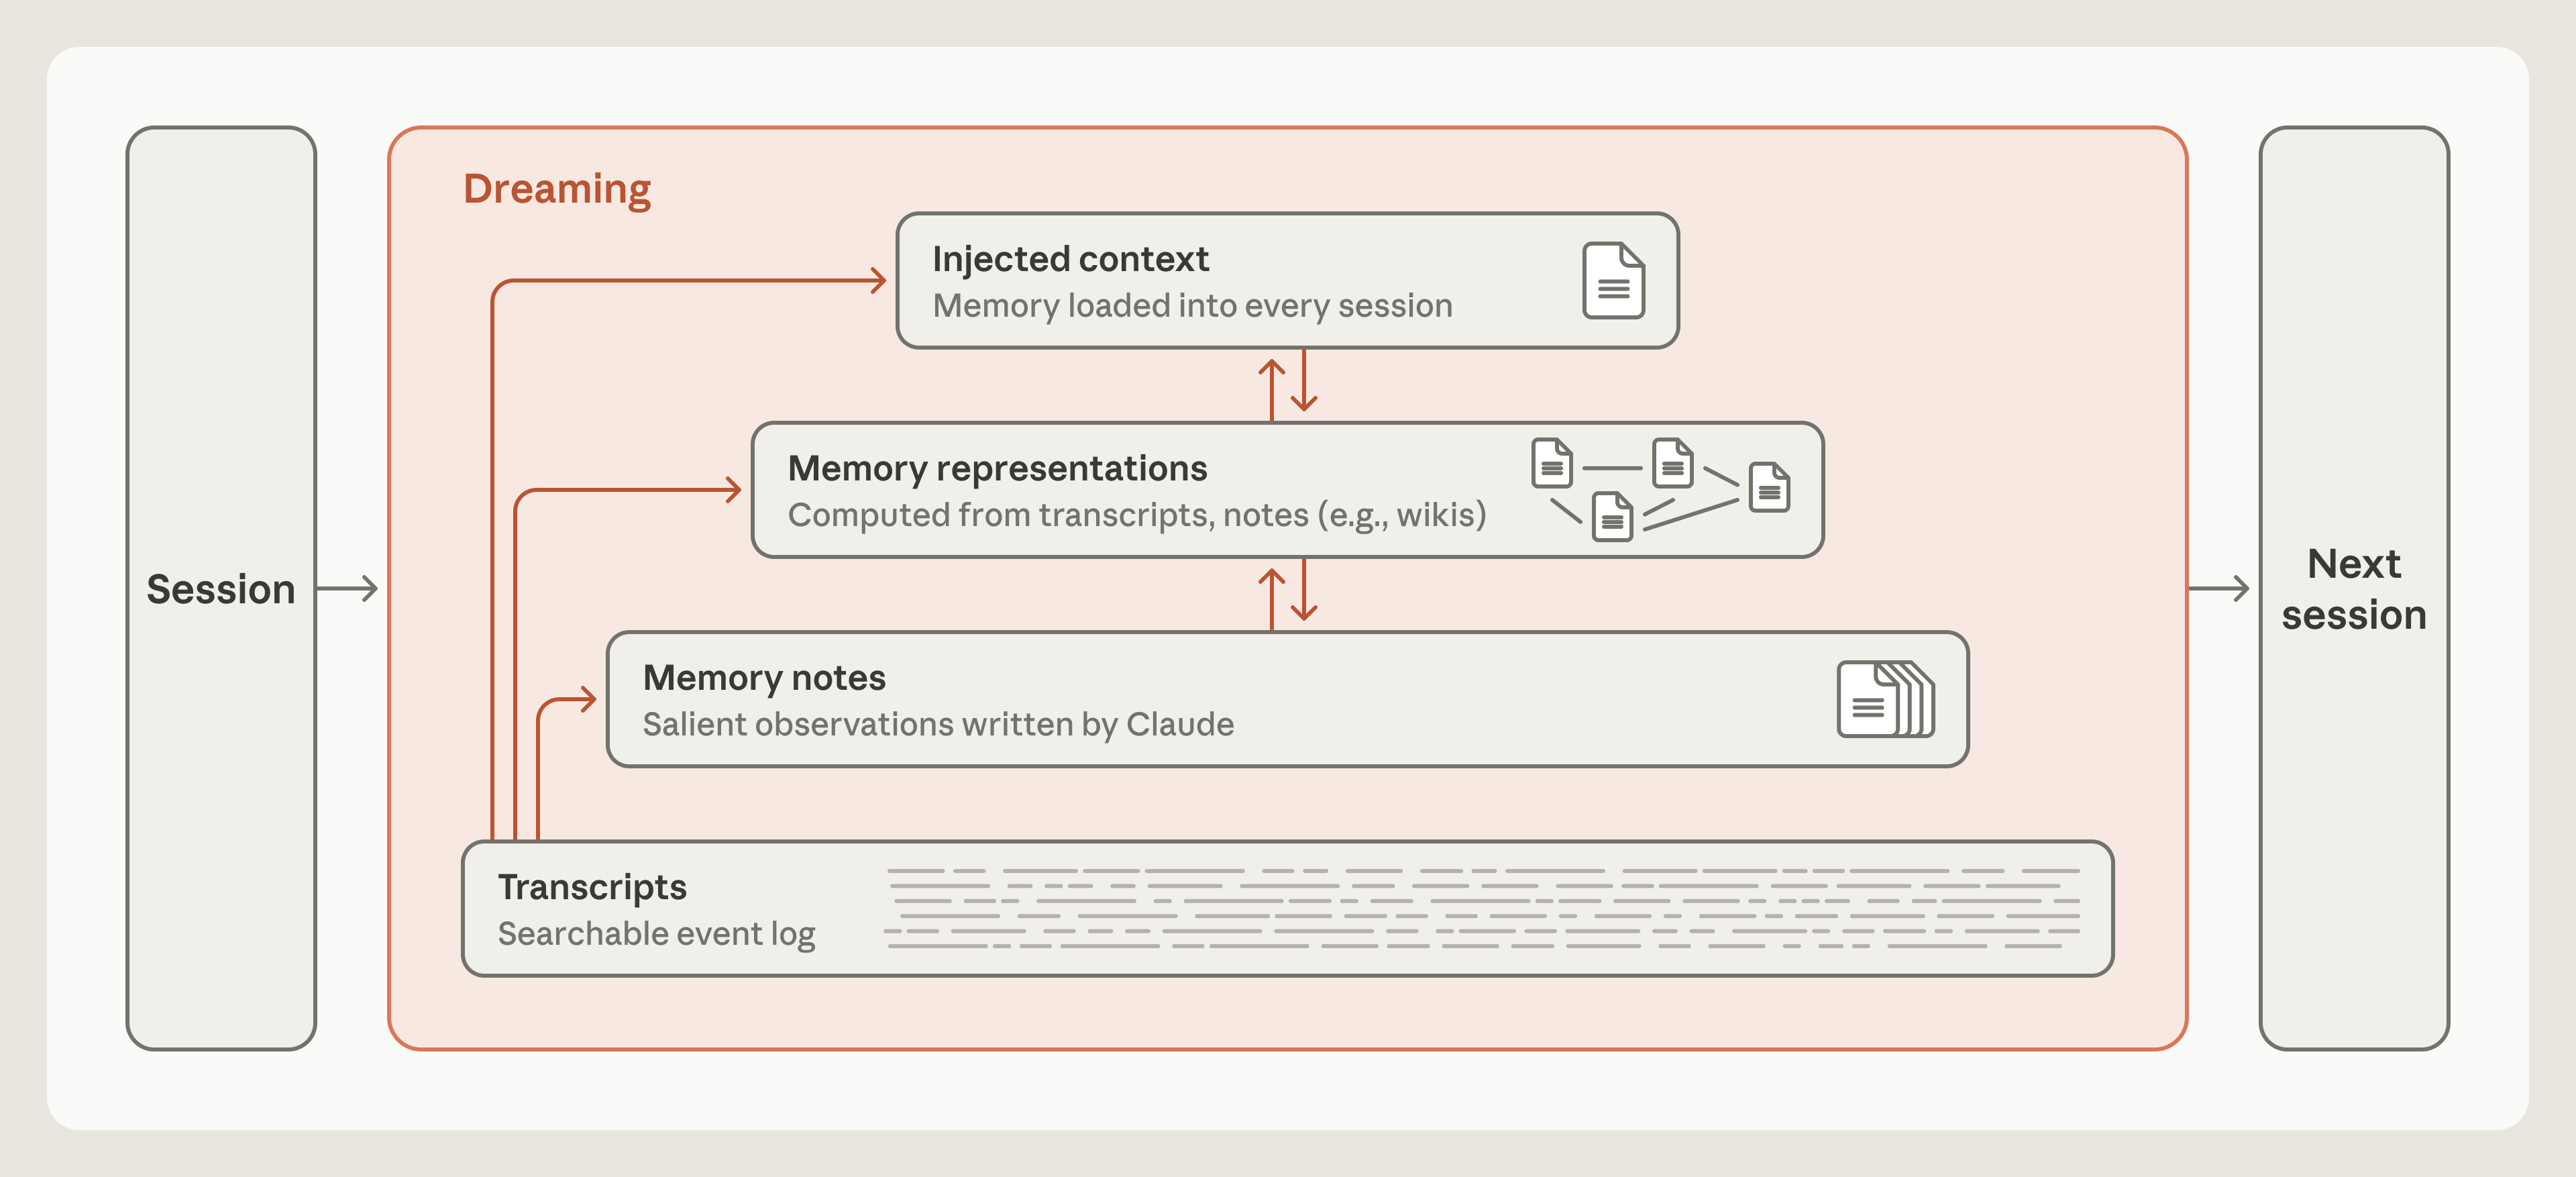
图源:Anthropic 原文。下面保留详细记录,上面放更容易找到和使用的内容。
通俗一点,我理解就是给 Agent 留一次“回头整理笔记”的机会。
我的 skill 目前主要是在做事的过程中记录,新增决定时检查相关旧记录;也支持专门审查重复或过时记录。但它不会因为装好了,就自己在后台定期运行。
如果想往这篇文章的方向再走一步,我可以在一个阶段结束后,让 Agent 专门检查相关记录:有没有和当前代码对不上的地方,有没有互相矛盾的决定,有没有已经解决却还挂着的提案。
先从手动触发开始就够了。整理时仍然需要核对代码、文档和实际讨论,不能让模型靠猜测补出一段“当时为什么这么决定”的故事。
Wiki 这一段,让我想到了做过的故障诊断 Agent
之前做过一个机器人故障诊断 Agent。机器人出错会上报错误码,Agent 根据错误码调用 MCP,拿到对应的解决文档,或者通过关键词继续排查。
但一个报错可能有多种原因,光看错误码对应的那一页文档,不一定能定位问题。有时候需要根据当前线索,继续找到其他相关文档。
看到原文的 Wiki,我就想到了 DeepWiki,也想到这类排障文档是不是可以这样组织起来。
比如,以一个假设的通信超时问题为例,入口页可以说明:需要先确认什么,不同现象分别去看哪份文档,哪些处理只适用于某种设备或版本。
这样 Agent 拿到的就不只是几篇“关键词相关”的文章,还能知道这些文章为什么有关,以及下一步该查什么。具体参数和操作步骤,还是回到原始文档核对。
这是我觉得值得尝试的方向,不过是否提高排障效率,还得用实际案例比较。可以拿同一批历史故障,分别用直接检索和 Wiki 辅助检索,看看有没有少读无关文档、少走错误分支。测试时不能提前把目标故障的最终答案放进去。
也不能为了做 Wiki,再复制一遍文档
原文里还有一个反例:生成的 Wiki 比原始材料还大。原文:Wiki 膨胀的案例
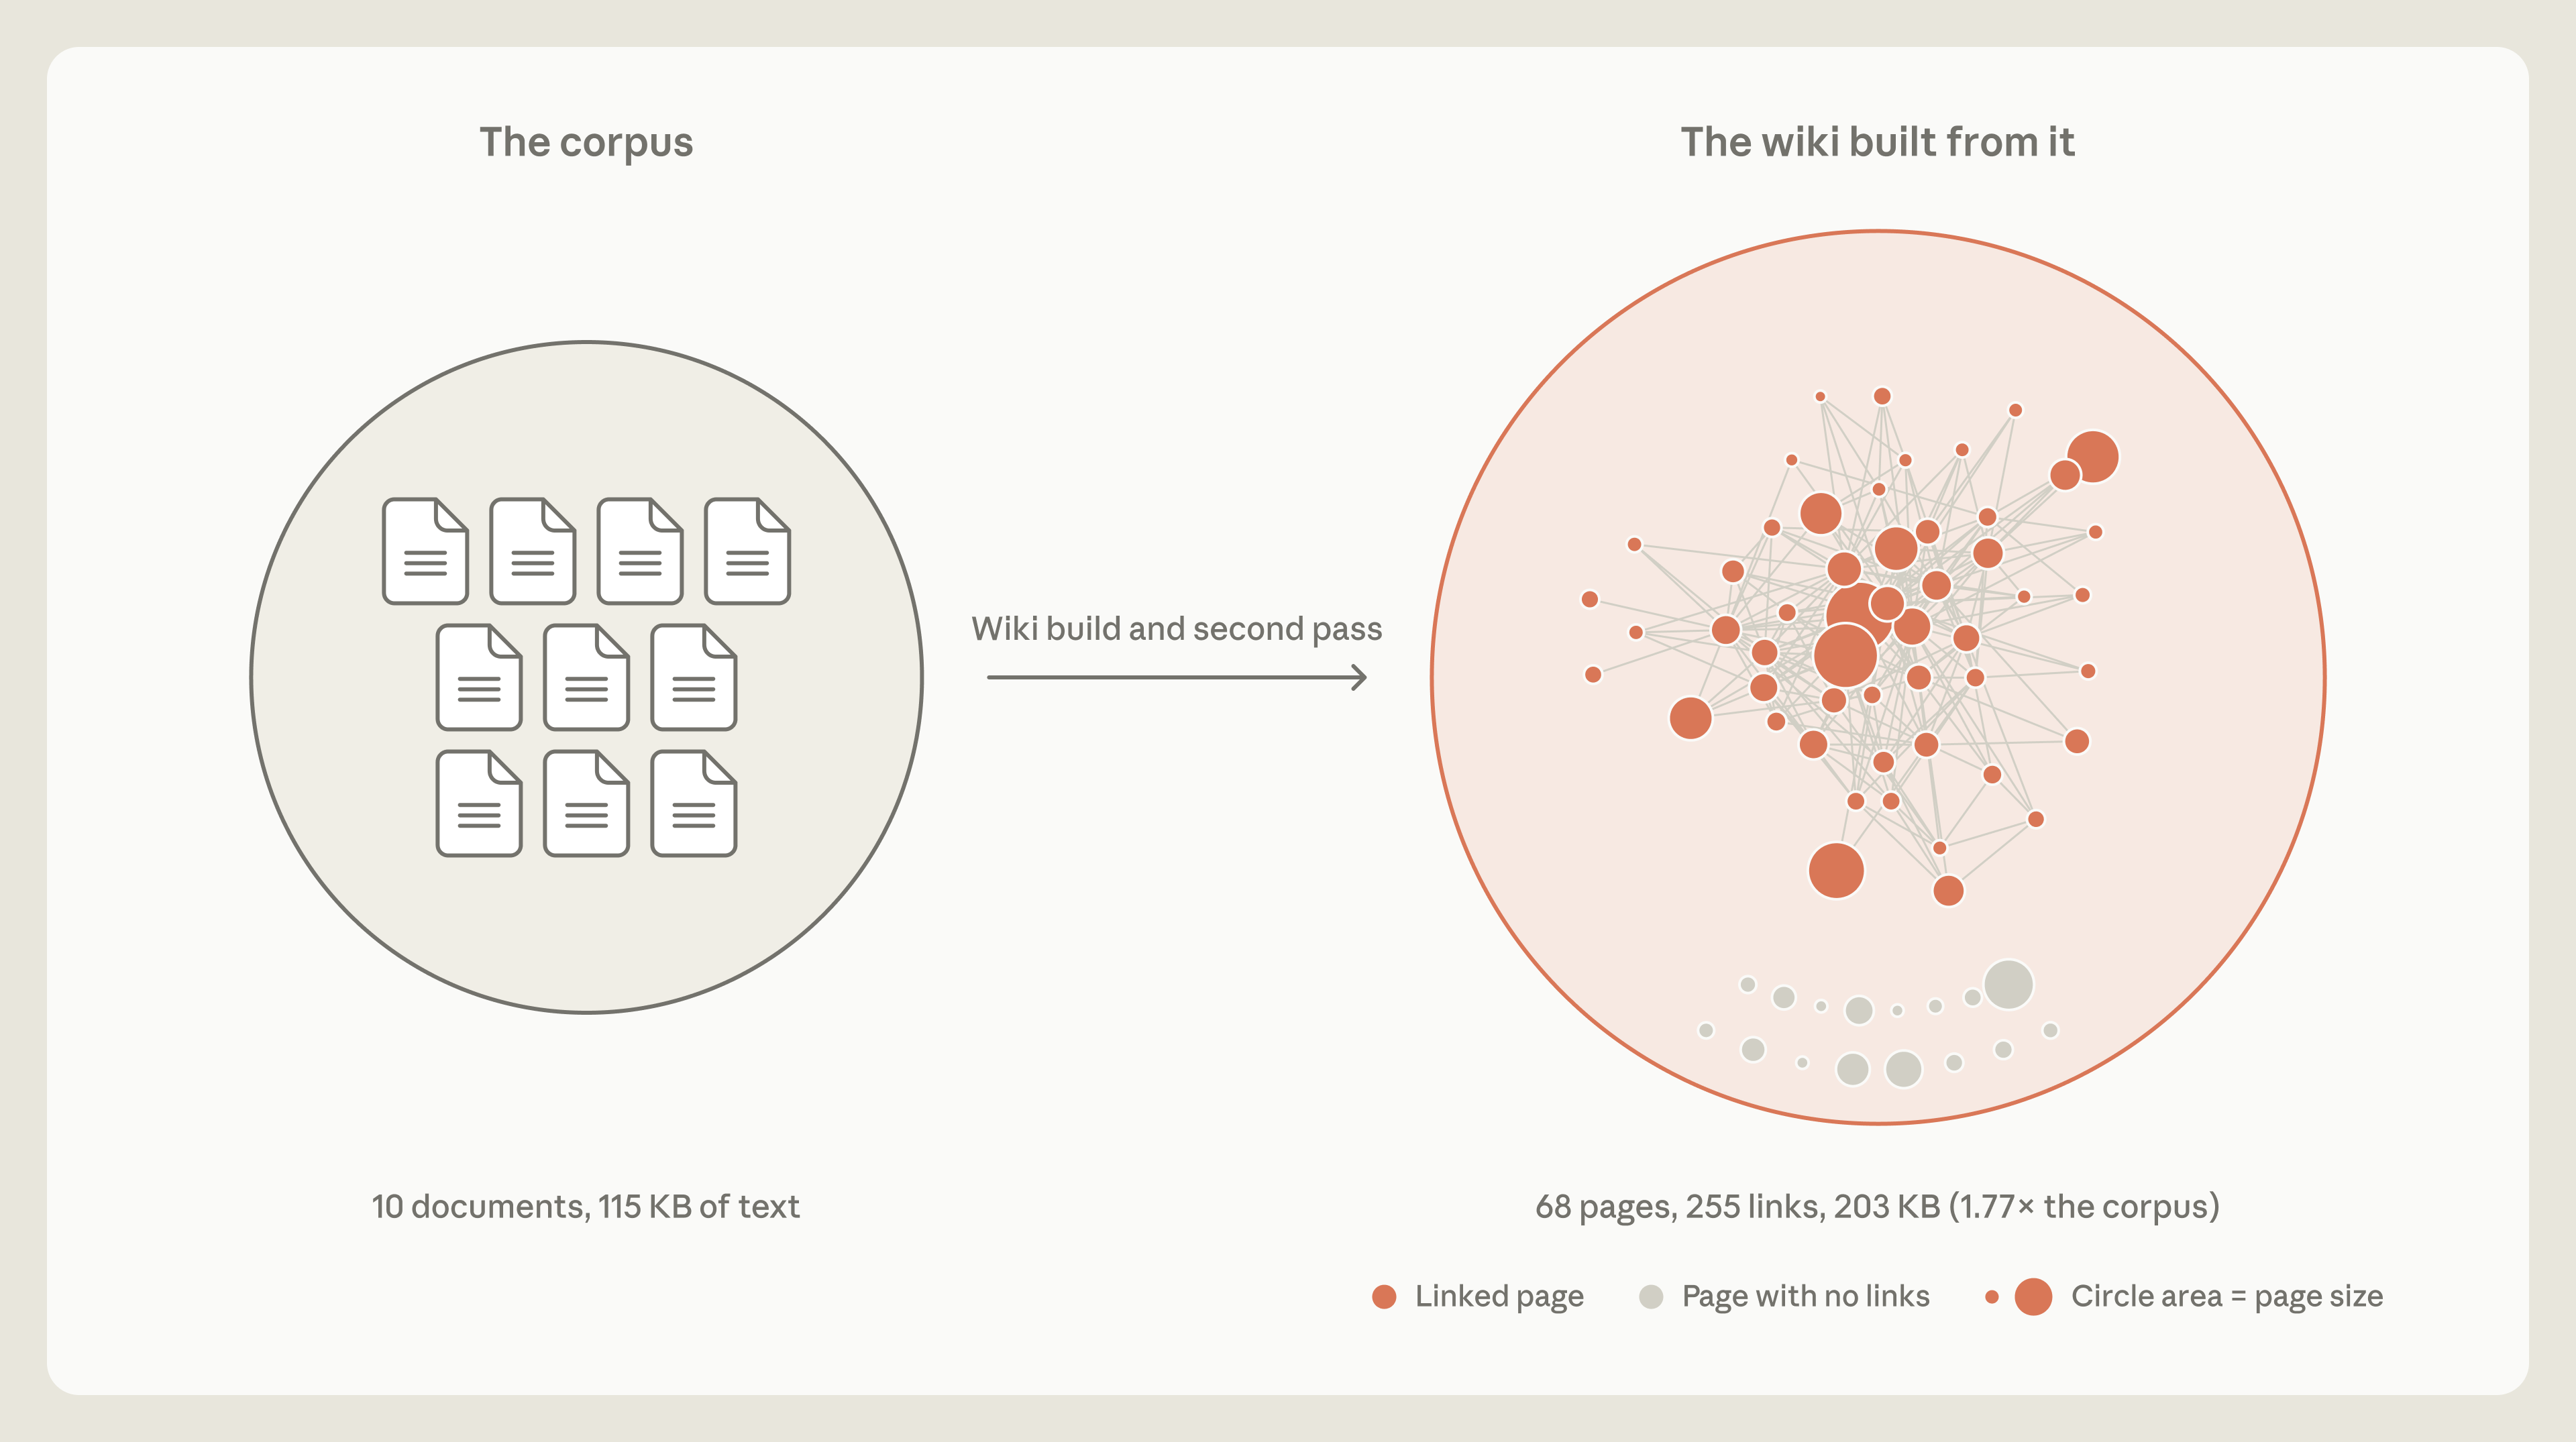
图源:Anthropic 原文。
我第一反应是,那直接看原文不就行了?之前用 DeepSeek harness 的时候,也遇到过压缩后的文本比压缩前还长,当时就觉得挺奇怪。
不过再想一下,Wiki 和压缩摘要的目的也不完全一样。多一些索引、解释和链接,确实可能让内容变长,但如果因此更好找东西,也有价值。
我现在更想看的是:它到底有没有帮 Agent 省掉查找和判断的时间。如果只是把原文换个说法重新写一遍,以后文档变了还要维护两份,那就没太大必要了。
总结
这次读文章,我觉得有意思的是,很多东西可能在公开讨论之前,大家就已经在各自做了。出发点不同,做法也不一样,最后却会在一些地方碰上。
比如我自己的 agent-notes,记录的是项目里重要决定的原因和取舍。对照这篇文章,就能看到相通的地方:有些信息没有留下来,下一个 Agent 就得重新摸索;留下来之后,还得能找到,也得随着项目变化更新。这次 DeepSeek 的 Super-agent 原型也让我想到这一点,仓库里明确提到,这套代码来自团队日常的开发工作。很多设计是在实际使用中一点点长出来的,公开之后,其他人才有机会把它和自己的做法放在一起看。
原文与配图来源:Anthropic — The components of agent memory。配图版权归原作者所有。
本博客所有文章除特别声明外,均采用 CC BY-SA 4.0 协议 ,转载请注明出处!